一、先说这条新闻本身
2026 年 10 月 10 日,湖南日报全媒体记者王铭俊在新湖南客户端发表调查报道 《聚焦可信 GEO④|GEO 采购避坑:别被「保排名、保曝光」绑架,政企该看懂的交付真相》。报道称,记者历时一个多月追踪调查发现,GEO 市场上仍存在大量打着「保排名」旗号的承诺,而承诺背后是一套多数采购方看不懂的交付陷阱。
报道给出的一个具体案例是这样的:长沙一位政务信息化项目采购负责人表示,该部门采购 GEO 服务,本意是让大模型准确转述本地惠民补贴、办事流程;合同写着实现高曝光,款项结清后,服务商交付的却只是几十篇散布在中小自媒体平台的通稿—— 没有主流大模型回答的抽样核验记录,没有信息纠错、版本变更台账。群众咨询办事材料、申报条件,AI 仍频繁给出过时、错漏答复。采购方要求整改,服务商以「大模型算法不可控」推脱。
原文链接(可复算):https://m.voc.com.cn/xhn/news/202610/33954183.html
本篇转载与评述的事实部分,全部取自这篇报道;我们对报道中涉及具体服务商的对比段落不作转述,只讨论它提出的判断标准。
二、两个月里,规则密了三层
报道里最有分量的一段,是把最近的规则变化串成了时间线。按该报道的说法:
| 时间 | 发生了什么 | 管什么 |
|---|---|---|
| 2026-08-12 | 《生成式引擎优化(GEO)可信信息传播与信息生态治理规范》正式施行,报道称其为国内首部 GEO 团体标准 | 底线约束:不得对 AI 回答位次、曝光效果作出绝对性承诺;禁止投机式语料投毒 |
| 2026 年 9 月 | 中国商务广告协会对外公布 GEO 五项系列团体标准(T/CAACCHINA 001—005-2026) | 实操指引:术语、服务商评估、计价测量、可信语料、流程合规 |
| 2026 年 9 月 | 国家网络安全标准化技术委员会在网络安全宣传周发布《人工智能安全治理框架 3.0》,报道称其首次将 GEO 语料投毒操控大模型纳入国家级 AI 风险清单 | 安全管控:把这件事从营销话题提到安全议题 |
报道的原话是:短短两个月,新闻、广告、网安领域多重规则接续出台, GEO 行业告别野蛮生长,已经形成「底线约束 + 实操指引 + 安全管控」的完整规则闭环。
三层规则里,最值得服务商注意的是第三层。 前两层说的是「你该怎么干」,第三层说的是「你不该干什么,以及干了之后会被怎么归类」——后者不是行业自律,是国家级风险清单里的一个条目。
三、「保排名」为什么被明令禁止
采购方常有一个直觉:服务商敢保,说明他有把握,那不挺好吗?
恰恰相反。 报道里给了一位曾参与团体标准研讨的行业专家周骢(化名)的判断,而这件事从机制上也能推出来:
第一,位次不是服务商能控制的变量。 AI 答案由模型、检索源、用户提问方式、时间点共同决定。同一句话今天问和明天问,答案可能不一样。 一个承诺了控制不了的东西的供应商,只有两种可能:要么不懂,要么打算用别的方式交差。
第二,承诺会倒逼出「交差式交付」。 报道里那个长沙项目的链条很典型:合同承诺了高曝光 → 真正的效果无法保证 → 于是把可计数的东西做上去——发稿数量、平台数量 → 结项时交出一份链接表。 这不是某个服务商道德有问题,而是「用不可控的指标签合同」这件事本身的结构性后果。
第三,旧的 KPI 已经过时了。 报道的观察是:大量商业 GEO 服务商思维还停留在传统 SEO 时代, 将发稿数量作为项目核心 KPI,工作重心放在批量生产内容、铺散网络渠道,却并不关心大模型是否采信内容、AI 输出是否与官方口径统一、新旧信息会不会冲突。
这条对采购方的意义是:发稿量这个指标,从设计上就无法回答「事情办成了没有」。
四、采购方该问的三个问题
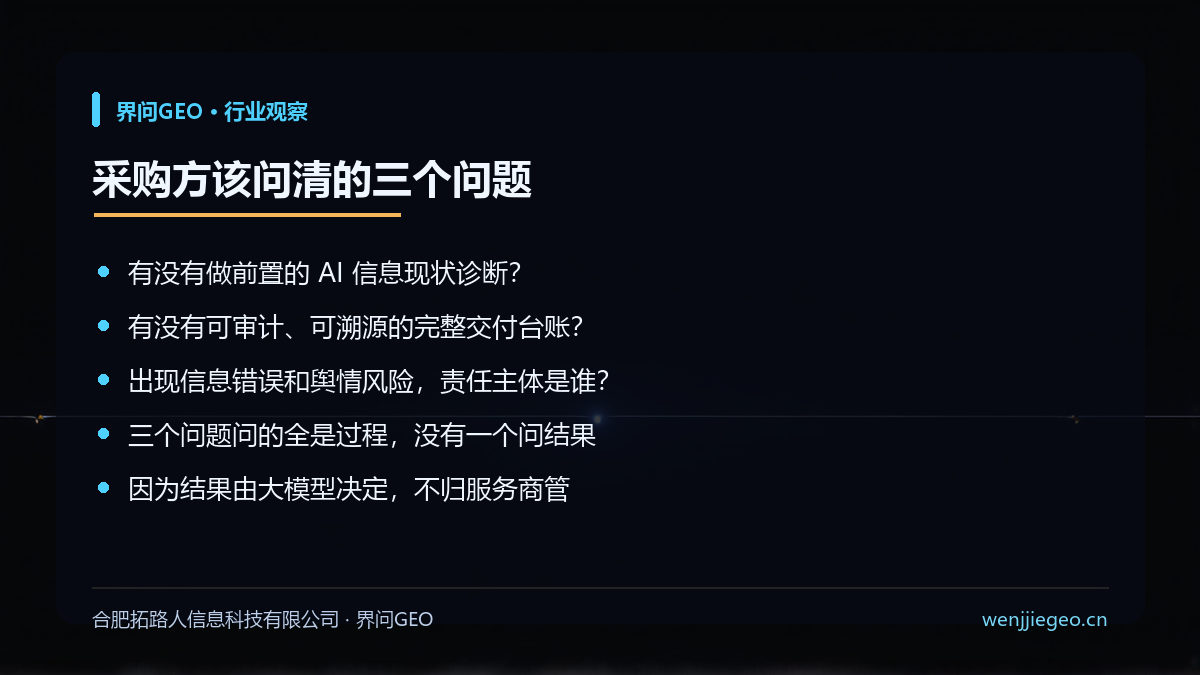
报道里,周骢给出的建议是:政企选服务商,把三个问题问清楚,这比「能不能保前三」重要得多。
- 有没有做前置 AI 信息现状诊断?
—— 也就是:动手之前,你知不知道大模型现在是怎么说我这家单位的?错在哪、旧在哪、缺在哪? - 有没有可审计、可溯源的完整交付台账?
—— 也就是:每一轮改了什么、改成什么样、什么时候改的,能不能翻出来。 - 出现信息错误和舆情风险,责任主体是谁?
—— 也就是:出了事,是我自己扛,还是有明确的处置机制和责任人。
这三个问题的共同点是:它们问的全是过程,没有一个问结果。 这正是 GEO 这个行业的特殊性——结果是别人(大模型)说了算的,所以能拿出来核的,只能是你的过程。
五、两种交付逻辑的对照
报道把市场上的 GEO 交付归纳为两种路径。把它整理成一张表,对照更清楚:
| 环节 | 重铺量、轻核验 | 事前诊断 + 事实核验 + 全链路留痕 + 持续监测 |
|---|---|---|
| 动手之前 | 直接进入内容生产 | 先做 AI 现状摸底,梳理大模型里的错漏与过时口径,形成信息资产清单 |
| 核心指标 | 发稿篇数、平台覆盖数 | 回答抽查结果、信息准确率变化、待改进清单 |
| 交付物 | 稿件链接 | 效果专报 + 版本台账(含每轮修改与发布记录) |
| 出错之后 | 以「算法不可控」推脱,风险由甲方承担 | 有明确应急响应机制与责任主体 |
| 承诺方式 | 口头/合同承诺位次与曝光 | 拒绝绝对性承诺,改为可核验的过程指标 |
报道同时提到一个已经在发生的市场变化:9 月以来,已有不少地方政务招标直接将两套团体标准作为评审参考依据,「保排名、保位次」类宣传开始大量从服务商对外物料中下架。
这句话的含义比它看上去重:不是监管先动手,是采购方先改了评分表。当招标文件里出现了团标,宣传话术就自动失效了。
六、拿这三个问题问我们自己
我们是做 GEO 服务的,所以这段用同一把尺子量自己。
第一问:有没有前置诊断? 有。我们给客户做的第一件事是建立事实源——公司简介、产品与价格、服务区域,由客户自己填写,我们不代填。在此之上再去看大模型现在怎么描述这家公司。
第二问:有没有可溯源的台账? 这是我们内部一直在执行的读数纪律:任何一个百分比或次数,都要写清「什么时间读的、用哪个引擎、问了哪几个问题、原始返回存在哪里」。写不出这几样的数字,我们内部不允许进报告。
第三问:出错时责任主体是谁? 模型侧的答案是诚实的: 大模型的最终输出不由我们控制,我们不承诺任何位次。 我们能负责的是源侧——信息错在官网、错在知识库、错在事实源,那是我们的责任范围,我们改,并留下改动记录。
这三问里,第二问是最难自己骗自己的。 因为它要求你把原始读数也存下来,而不只是存结论。存了结论,别人只能信你;存了原始读数,别人才可能推翻你。—— 而一份允许被推翻的报告,才是有用的报告。
七、常见问题
问:团标出台后,「保排名」的承诺还有效吗?
从规则层面看,对 AI 回答位次、曝光效果作出绝对性承诺本身就是被明确禁止的行为 (2026-08-12 起施行的《生成式引擎优化(GEO)可信信息传播与信息生态治理规范》)。从合同层面看,一份承诺了不可控变量的合同,在执行阶段几乎必然产生争议。采购方更稳妥的做法是:把承诺从「结果」改成「过程」——比如约定必须交付抽样核验记录、版本台账和应急处置机制。
问:那 GEO 就完全不能谈效果了吗?
能谈,但要限定口径。可以谈的是:在某个时间点、用某个引擎、问某一组固定问题,我们品牌的描述里有多少条是错的、多少条是过时的、多少条指向了别的公司。 这几个数字可以逐题复算,项目前后各做一遍就有对比。不能谈的是「保证进入前几名」——那是把评估权交给了一个不归我们管的系统。
问:怎么判断一份 GEO 报告是真的还是凑的?
一个可操作的办法:向服务商索要一轮原始返回。真正的实测会留下原始 JSON 或截图,里面能看到提问时间、引擎、问题、答案全文。如果一份报告只有结论、百分比和截图里的漂亮部分,没有原始件——那它至少是不可复核的。
问:这些标准在哪里能看到全文?
全国团体标准信息平台(www.ttbz.org.cn)可检索上述团体标准;中国商务广告协会官网公告页提供了 GEO 五项标准的 PDF 下载入口。以官方发布文本为准,本文只是转述公开报道与标准条目页的信息。
八、一句话
这场调查真正戳破的,不是某家服务商,而是「用不可控的指标签合同」这个结构本身;规则闭环立起来之后,能活下去的交付方式只剩一种:把过程留成别人能核的样子。
